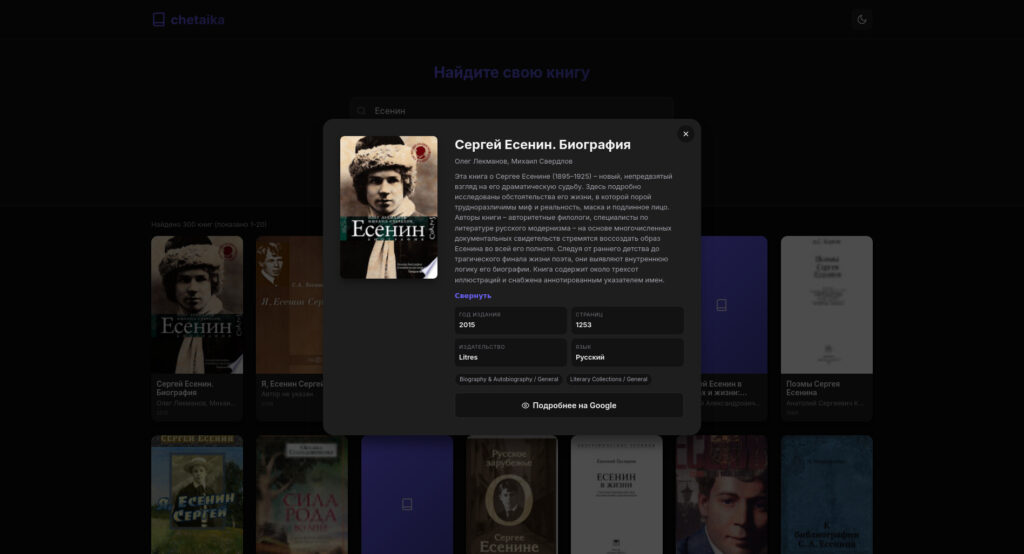
Задача
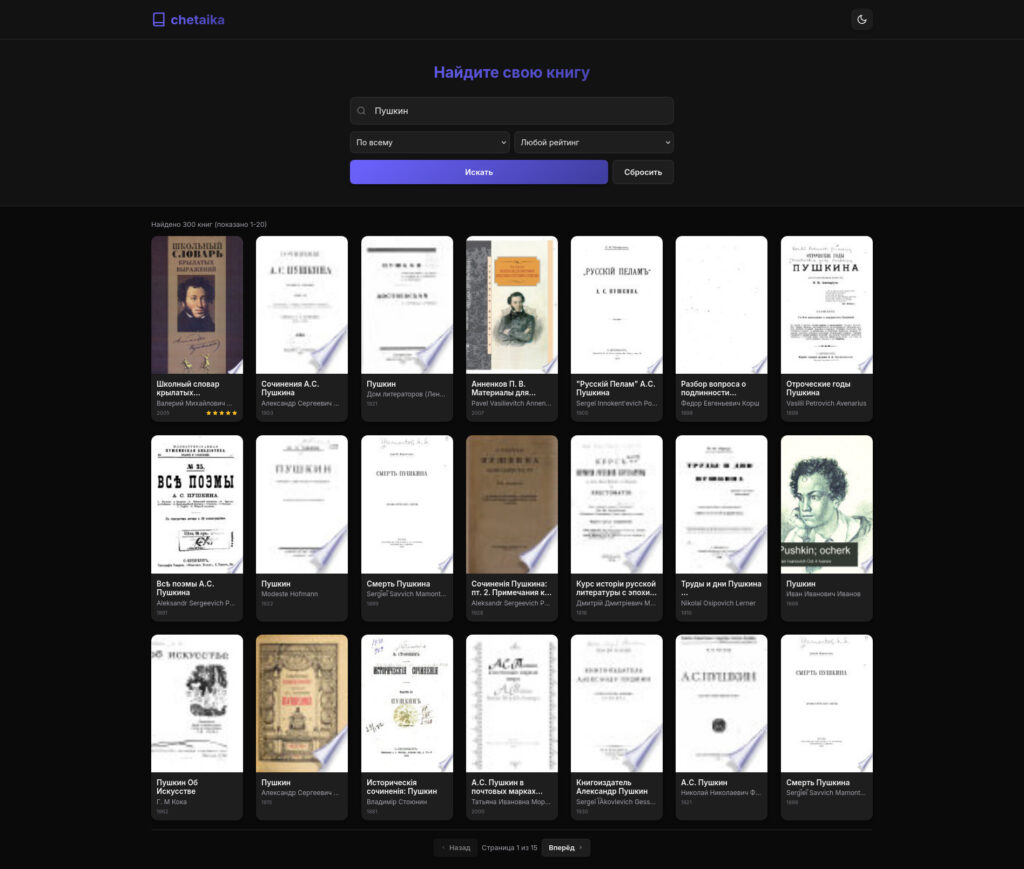
Сделать рабочий поисковик книг поверх Google Books API. Сложность не в запросах, а в том, что API отдаёт данные как попало: обложки по http://, рейтинги без возможности фильтрации, totalItems, который считает не всё, и молчаливый игнор maxResults больше 40.
Как делал
Два serverless-хендлера проксируют Google Books и держат ключ в переменной окружения, а не в браузере. Ответ отдаётся с s-maxage=600, stale-while-revalidate=1200 — платформа кэширует его на 10 минут и ещё 20 отдаёт устаревшую копию, пока обновляется фоновая. Для книг это бесплатный обход лимитов.
const GOOGLE_BOOKS_API = 'https://www.googleapis.com/books/v1/volumes';

module.exports = async function handler(req, res) {
  const apiKey = process.env.GOOGLE_BOOKS_API_KEY;
  const { id } = req.query;

  try {
    const response = await fetch(`${GOOGLE_BOOKS_API}/${id}?key=${apiKey}`);
    if (!response.ok) return res.status(response.status).json({ error: 'API error' });

    res.setHeader('Cache-Control', 's-maxage=600, stale-while-revalidate=1200');
    return res.status(200).json(await response.json());
  } catch (error) {
    return res.status(500).json({ error: 'Failed to fetch book details' });
  }
};
Обложки приходят по http:// и с размытым zoom=3, поэтому нормализуются цепочкой замен. Приоритет у smallThumbnail парадоксальный: с zoom=1 она отдаёт ту же картинку, что и thumbnail, но весит меньше. Если ссылки нет — рендерится SVG-плейсхолдер с градиентом.
const normalize = (url) =>
  url?.replace('http:', 'https:')?.replace('zoom=3', 'zoom=1');

const coverUrl = normalize(imageLinks?.smallThumbnail) ||
                 normalize(imageLinks?.thumbnail) || null;
Поиск запускается не на каждую букву, а через 500 мс после последнего нажатия и только от трёх символов — иначе на «а», «аб», «абв» улетели бы три запроса, и последний ответ мог бы прийти раньше среднего.
let debounceTimer;
elements.searchInput.addEventListener('input', () => {
  clearTimeout(debounceTimer);
  debounceTimer = setTimeout(() => {
    if (elements.searchInput.value.length >= 3) handleSearch();
  }, 500);
});
Фильтр по рейтингу Google Books не поддерживает вообще, поэтому применяется на клиенте после ответа. Плата — пагинация врёт: totalItems обещает тысячи, а на экране после фильтра может остаться пять книг.
Звёзды рисуются из целой части и дробной: полная — fill="currentColor", половина — та же звезда с opacity="0.5", пустая — fill="none". Порог rating % 1 >= 0.5, потому что 4.5 должно дать половину, а 4.4 — уже нет, и простое округление вниз тут не подходит.
function createRatingStars(rating) {
  const fullStars = Math.floor(rating);
  const hasHalfStar = rating % 1 >= 0.5;
  let stars = '';

  for (let i = 0; i < 5; i++) {
    if (i < fullStars)          stars += star('currentColor');
    else if (i === fullStars && hasHalfStar) stars += star('currentColor', 0.5);
    else                          stars += star('none');
  }
  return `<div class="book-rating">${stars}</div>`;
}
Кнопка «Показать полностью» появляется только если описание действительно обрезано, а проверка идёт в requestAnimationFrame: -webkit-line-clamp применяется после рендера, и сразу после вставки в DOM scrollHeight ещё равен clientHeight.
requestAnimationFrame(() => {
  if (modalDesc.scrollHeight <= modalDesc.clientHeight) {
    toggleBtn.style.display = 'none';
    modalDesc.classList.remove('truncated');
  }
});
Итог
Три статических файла и два хендлера, ноль зависимостей: ни React, ни Tailwind, ни Axios — только fetch, CSS-переменные и localStorage. Вся кривая оболочки Google Books — разбор http:// в ссылках, фильтрация без поддержки на стороне API, кэш в заголовке и пересчёт вёрстки после смены display — закрыт на стороне фронтенда.