Задача
Нужна цена по конкретному ID товара на Ozon для выгрузки в 1С — не для разового просмотра, а для регулярного обновления. Ozon держит цену в живом DOM приложения и не отдаёт её в исходном HTML, поэтому BeautifulSoup здесь бесполезен.
Вторая сложность — антибот. Площадка проверяет не только разметку, но и поведение: холодный браузер на карточку товара получает abt-challenge вместо товара. Значит скрипт должен уметь сам выйти из этого состояния и продолжить работу, а не просто упасть.
Как делал
Playwright поднимает установленный Chrome вместо своего Chromium: лишние 150 МБ не нужны, а для обхода проверки важно, чтобы это был реальный браузер пользователя. Список путей широкий — Windows, Linux, Edge, Brave, — и только если ничего не нашлось, скрипт пробует каналы chrome и msedge.
BROWSER_PATHS = [
    r"C:\Program Files\Google\Chrome\Application\chrome.exe",
    os.path.expandvars(r"%LOCALAPPDATA%\Google\Chrome\Application\chrome.exe"),
    r"C:\Program Files (x86)\Microsoft\Edge\Application\msedge.exe",
    "/usr/bin/google-chrome-stable",
    "/usr/bin/chromium",
    "/snap/bin/chromium",
    "/usr/bin/brave-browser",
]

def detect_browser():
    for p in BROWSER_PATHS:
        if os.path.exists(p):
            return p
    return None
На --no-sandbox добавлен только для Linux: в контейнерах и под root Chrome без него не стартует, а на Windows флаг вызывает лишнее предупреждение. Дальше --disable-blink-features=AutomationControlled и init-скрипт убирают navigator.webdriver, который Playwright выставляет честно и всегда.
Отдельная тонкость — User-Agent. В headless Chrome подставляет HeadlessChrome, и Ozon реагирует на это слово мгновенно. Скрипт открывает служебную страницу, читает настоящий UA движка и меняет в нём HeadlessChrome на Chrome. Так подмена точно совпадает с версией браузера, а не собирается вручную.
user_agent = None
try:
    probe = browser.new_page()
    raw_ua = probe.evaluate("navigator.userAgent")
    probe.close()
    if headless:
        user_agent = raw_ua.replace("HeadlessChrome", "Chrome")
except Exception:
    pass

kwargs = {
    "viewport": {"width": 1600, "height": 1000},
    "locale": "ru-RU",
    "timezone_id": "Europe/Moscow",
    "color_scheme": "light",
}
if user_agent:
    kwargs["user_agent"] = user_agent
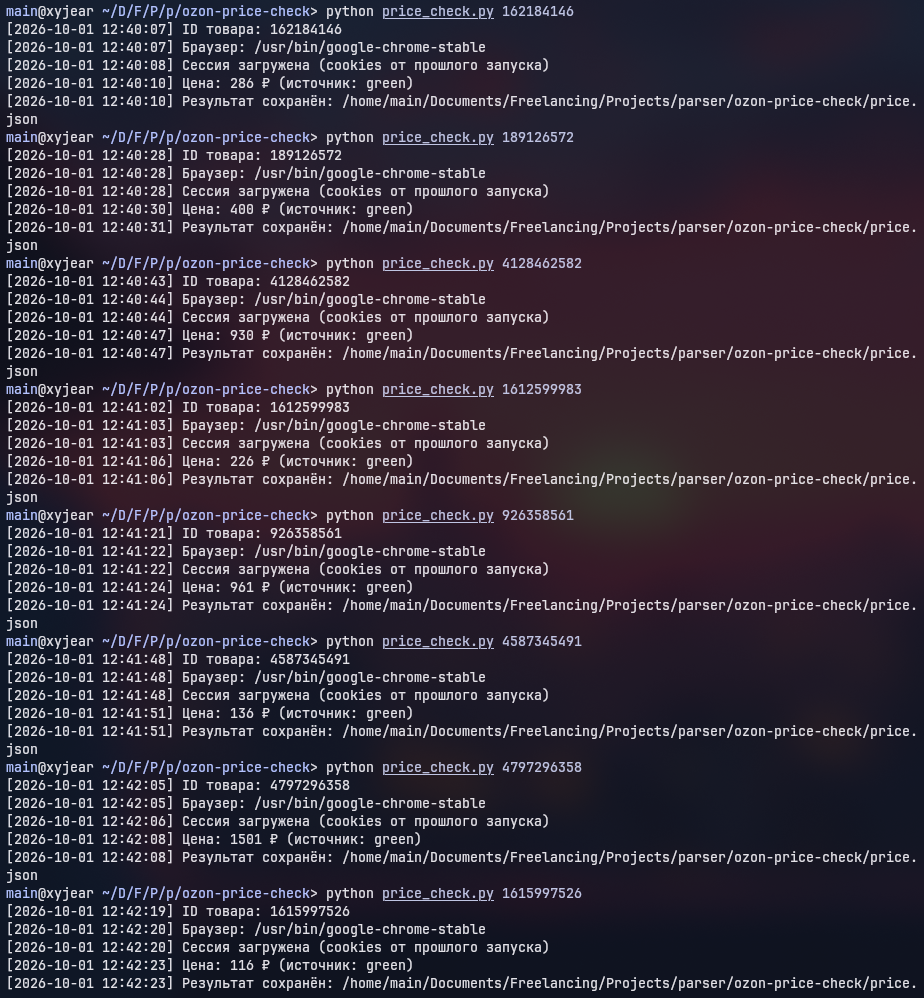
Цена читается в два захода, и порядок важен: сначала зелёная плашка span.tsHeadline600Large — это цена с Ozon Card, которую видит покупатель, и только потом обычная span.pdp_ib0. Источник пишется в лог, чтобы было видно, что именно вернулось.
GREEN_PRICE_SELECTOR = "span.tsHeadline600Large"   # цена с Ozon Card
REGULAR_PRICE_SELECTOR = "span.pdp_ib0"           # обычная цена, фолбэк

def extract_price_from_dom(page):
    for selector, source in ((GREEN_PRICE_SELECTOR, "green"),
                             (REGULAR_PRICE_SELECTOR, "regular")):
        try:
            el = page.query_selector(selector)
            if el:
                price = str_price_to_num(el.inner_text())
                if price:
                    return price, source
        except Exception:
            pass
    return None, None
Антибот у Ozon приходит двумя разными лицами. Первый — обычная страница-заглушка с пазлом, она ловится по URL и по слову «пазл» в тексте. Второй интереснее: вместо капчи отдаётся белая страница «Похоже, нет соединения» с меткой инцидента fab_chlg. Формально это не капча, но товара там тоже нет, поэтому оба случая свожу к одному статусу.
def page_is_captcha(page):
    url = page.url
    if "abt-challenge" in url or "captcha" in url.lower():
        return True
    try:
        title = page.title()
        if "antibot" in title.lower():
            return True
    except Exception:
        pass
    text = page.inner_text("body")[:500].lower()
    if "пазл" in text or "не бот" in text or "подтвердите, что" in text:
        return True
    # fab-челлендж: «Похоже, нет соединения … Инцидент: fab_*» без данных
    if "fab_chlg" in text or "fab_" in text:
        return True
    if "похоже, нет" in text and "соединения" in text:
        return True
На капчу заложено до 180 секунд, и только что решённая проверка даёт свежий полный таймаут на данные — иначе после неё вылетал бы лимит, выбранный до капчи. В headless ждать бессмысленно, там пазл некому решать, поэтому вместо ожидания скрипт сразу перезапускается в видимом окне.
# --- Попытка 1: headless (без окна). Быстро и незаметно. ---
status = "timeout"
pw, browser, ctx, page = launch_browser(headless=not args.headed)
try:
    status = collect_price(page, url, args.timeout, headless=not args.headed)
    price, source = extract_price_from_dom(page)
    if status == "price" and price:
        result["price"] = price
        log(f"Цена: {price} ₽ (источник: {source})")
    save_state(ctx)
close_browser(browser, pw)

# --- Попытка 2 (только если капча): видимое окно для ручного решения. ---
if status == "captcha" and not result.get("error"):
    log("Перезапускаю в видимом окне — решите пазл, если появится")
    pw, browser, ctx, page = launch_browser(headless=False)
Ложное срабатывание на «товар не найден» приходится гасить отдельно: селектор цены одинаково совпадает в блоке рекомендаций внизу страницы. Поэтому наличие селектора само по себе ничего не значит — скрипт дожидается, пока цена реально распарсится в число, и только потом признаёт страницу удачной.
Ошибки в JSON отдаются словами, а не кодами, иначе вызывающий не поймёт, что произошло:
| error | Что случилось |
|---|---|
not_found | Товар удалён или ID неверный |
blocked | Ozon не пропустил после капчи |
network_error | Данные не появились за отведённое время |
exception | Внутренний сбой при работе с браузером |
Итог
Результат — price.json, при ошибке он всё равно пишется, чтобы 1С всегда читала актуальное состояние, а не старые данные. Запись атомарная: сначала временный файл, потом os.replace, поэтому 1С не прочитает наполовину записанный JSON.
Вход принимает и просто nmId, и полную ссылку, и параметр nm= в URL — регулярки покрывают все три формата, которые приходят из учётной системы. Файлы сессии, логов и результата лежат рядом со скриптом по абсолютным путям, потому что 1С вызывает его с произвольным рабочим каталогом.
Работает на Windows и Linux одинаково, есть setup.bat и текстовая инструкция для клиента. Селекторы Ozon меняет вместе с вёрсткой — как и у любого такого скрипта, это слабое место, чинить придётся по логу.